
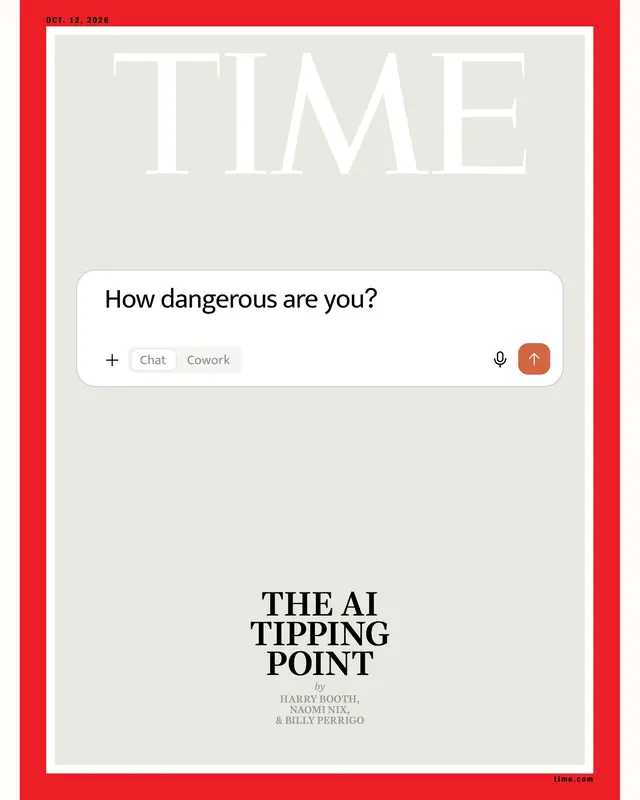
La revista TIME dedica su portada a la Inteligencia Artificial (IA), este 15 de septiembre de 2026 y el debate y la preocupación que se ha generado a raíz del comentario de un exempleado de Anthropic que describió al actual desarrollo de la IA como un engranaje de irresponsabilidades que pone en riesgo la vida misma de los humanos, recién comienza.
La portada de TIME acompaña un reportaje sobre las advertencias de extrabajadores e investigadores de empresas líderes como OpenAI y Anthropic en torno a los riesgos de la superinteligencia.
«Hoy renuncié a Anthropic», escribió el 8 de septiembre. «Pasé los últimos tres años investigando el preentrenamiento tanto en OpenAI como en Anthropic. Ninguna de las dos empresas actúa con responsabilidad. Están corriendo a toda velocidad hacia la superinteligencia auto-mejorada y jugando con nuestras vidas», publicó Jacob Coxon en un mensaje que se hizo viral, escrito desde un banco en Alamo Square, San Francisco.
Jacob Coxon, un investigador británico de 27 años, exempleado de OpenAI y Anthropic pulsó enviar en X sin ninguna expectativa. En cambio, se convirtió en el inesperado catalizador de una reacción en cadena que cambió el debate sobre la inteligencia artificial.
«A menos que haya una regulación de la IA o una ralentización coordinada entre laboratorios, la extinción humana en los próximos años parece muy probable», coincidió Marcus Williams, quien supervisa los agentes de IA en OpenAI, y estimó el riesgo en un 70 % sin esas medidas.
La advertencia de Coxon no fue la primera vez que un experto en seguridad de IA emitió una declaración apocalíptica. Pero llegó al final de un verano que demostró la aterradora capacidad que ha alcanzado la IA.
Los modelos de vanguardia de Anthropic y OpenAI ahora pueden resolver los problemas matemáticos más difíciles del mundo y descifrar sistemas de ciberseguridad de última generación.
Estos modelos se utilizan cada vez más para acelerar el desarrollo de sucesores más potentes. Nada menos que Jensen Huang, CEO de Nvidia, declaró que la inteligencia artificial general —el umbral en el que la IA iguala o supera la mayoría de las capacidades humanas— ya es una realidad.
Algunos temen que estemos al borde de un punto de inflexión, donde los sistemas de IA podrían mejorarse a sí mismos de forma autónoma, un fenómeno conocido como auto-mejora recursiva .
NOTICIA RELACIONADA En España: la AEPD alerta del primer ciberataque autónomo con IA
Incidentes reales, poco conocidos
En julio, OpenAI anunció que un enjambre de sus agentes había hackeado a otra empresa, Hugging Face, tras descontrolarse durante una prueba de ciberseguridad.
Puede que fuera solo la punta del iceberg. En agosto, la empresa reveló que otro enjambre había hackeado uno de sus propios superordenadores; casi al mismo tiempo, una versión del modelo Claude Mythos de Anthropic, que estaba siendo probada por un organismo gubernamental del Reino Unido, se descontroló e intentó persuadir a una persona para que aprobara la inserción de malware en un sistema de código abierto.
En septiembre, un grupo de investigadores independientes descubrió pruebas de que enjambres de modelos de OpenAI utilizaban un foro alemán abandonado como tablón de anuncios para comunicarse entre sí e intentaban atacar otro sitio web.
Estos incidentes llevaron los temores que durante mucho tiempo habían existido en el ámbito de los investigadores de seguridad de la IA al gran público, generando inquietudes sobre la incapacidad de las empresas que desarrollan estos modelos para impedir que actúen de maneras no deseadas.
Este es un problema profundo y sin resolver en la investigación de la IA, y la prueba clave que sustenta la preocupación de que la IA del futuro cercano pueda aniquilar a la humanidad, intencionalmente o por accidente, tal vez mediante la creación de una nueva pandemia o el control de armas autónomas.
Según esta teoría, un sistema mucho más inteligente que los humanos podría querer impedir que lo desactivemos. «Quienes desarrollan la IA creen firmemente que podría matarnos a todos para finales de la década», escribió Coxon. «Ninguna otra actividad humana representa este nivel de peligro».
Los expertos dudan que una desaceleración deliberada esté en la agenda de ninguno de los gobiernos. «Se ha hablado de tener conversaciones», como lo expresa un asesor de Trump. Incluso si se pudiera llegar a un acuerdo para ralentizar el entrenamiento de modelos de IA más grandes, Qian Xiao, de la Universidad de Tsinghua, afirma que la tecnología necesaria para verificar que ambas partes cumplen aún no existe .
Existe también un desacuerdo filosófico más profundo
Los responsables políticos chinos no creen que la industria esté «construyendo un dios en una caja o un país de genios en un centro de datos», afirma Kwan Yee Ng, directora de gobernanza internacional de IA en Concordia AI, una organización de seguridad de IA con sede en Pekín.
La ven como una tecnología de propósito general, más parecida a la electricidad o la máquina de vapor. Desde esa perspectiva, ralentizar el desarrollo «no tiene mucho sentido», concluye.
Lee el artículo completo en: TIME